Proxmox VE High Availability Cluster และกลไก Automated Failover ในทางปฏิบัติ
คู่มือปฏิบัติการตั้งค่า HA Cluster บน Proxmox VE 9.2 อธิบายการทำงานของ Cluster Resource Manager และ Local Resource Manager เงื่อนไขที่ต้องเตรียมก่อนเปิดใช้งาน การกำหนดค่าทรัพยากรด้วย ha-manager รวมถึงลำดับเหตุการณ์เมื่อโหนดล้มเหลวและแนวทางป้องกันความเสียหายจาก Split-Brain
ปัญหาและโจทย์
องค์กรที่วางระบบเสมือนจริงไว้บน Proxmox VE แล้ว มักพบว่าความพร้อมใช้งานยังขึ้นอยู่กับคนเป็นหลัก เมื่อเซิร์ฟเวอร์เครื่องใดเครื่องหนึ่งมีปัญหาฮาร์ดแวร์ ผู้ดูแลระบบต้องได้รับแจ้ง ตรวจสอบ และทยอยเปิดเครื่องเสมือนขึ้นใหม่บนเครื่องอื่นด้วยมือ ซึ่งใช้เวลาตั้งแต่หลายนาทีจนถึงหลายชั่วโมง ขึ้นอยู่กับว่าเหตุเกิดเวลาใด
ยิ่งไปกว่านั้น หากเครื่องเสมือนยังใช้อุปกรณ์จัดเก็บข้อมูลภายในเครื่องนั้นเอง แม้จะเปิดเครื่องเสมือนบนโหนดอื่นได้ ก็ยังไม่สามารถเข้าถึงดิสก์เดิมได้ กลายเป็นว่าความพร้อมใช้งานที่แท้จริงถูกจำกัดด้วยสถาปัตยกรรมระบบจัดเก็บ ไม่ใช่ด้วยคุณภาพของเซิร์ฟเวอร์
ความเสี่ยงที่รุนแรงกว่าการหยุดให้บริการชั่วคราว คือกรณีที่โหนดยังทำงานอยู่แต่ขาดการติดต่อกับโหนดอื่น แล้วตัดสินใจเดินหน้าให้บริการต่อไปทั้งสองฝั่ง ซึ่งเอกสารทางการของ Proxmox VE ระบุว่ากรณีเช่นนี้จะถูกจัดการด้วยกลไก Fencing เพื่อไม่ให้โหนดที่ถูกตัดขาดกลับมาแย่งใช้ข้อมูลร่วมกันในภายหลัง
แนวทางการแก้ปัญหา: HA Stack ของ Proxmox VE
Proxmox VE มาพร้อมสแตกซอฟต์แวร์ชื่อ ha-manager ซึ่งทำงานเสมือนเป็นผู้ดูแลระบบอัตโนมัติ คอยเฝ้าสังเกตว่าทรัพยากรที่กำหนดไว้ทำงานปกติหรือไม่ และสั่งย้ายบริการไปยังโหนดอื่นเมื่อตรวจพบความผิดพลาด โดยไม่ต้องรอการตัดสินใจของมนุษย์
1. สองดีมอนที่ทำงานคู่กันบนทุกโหนด
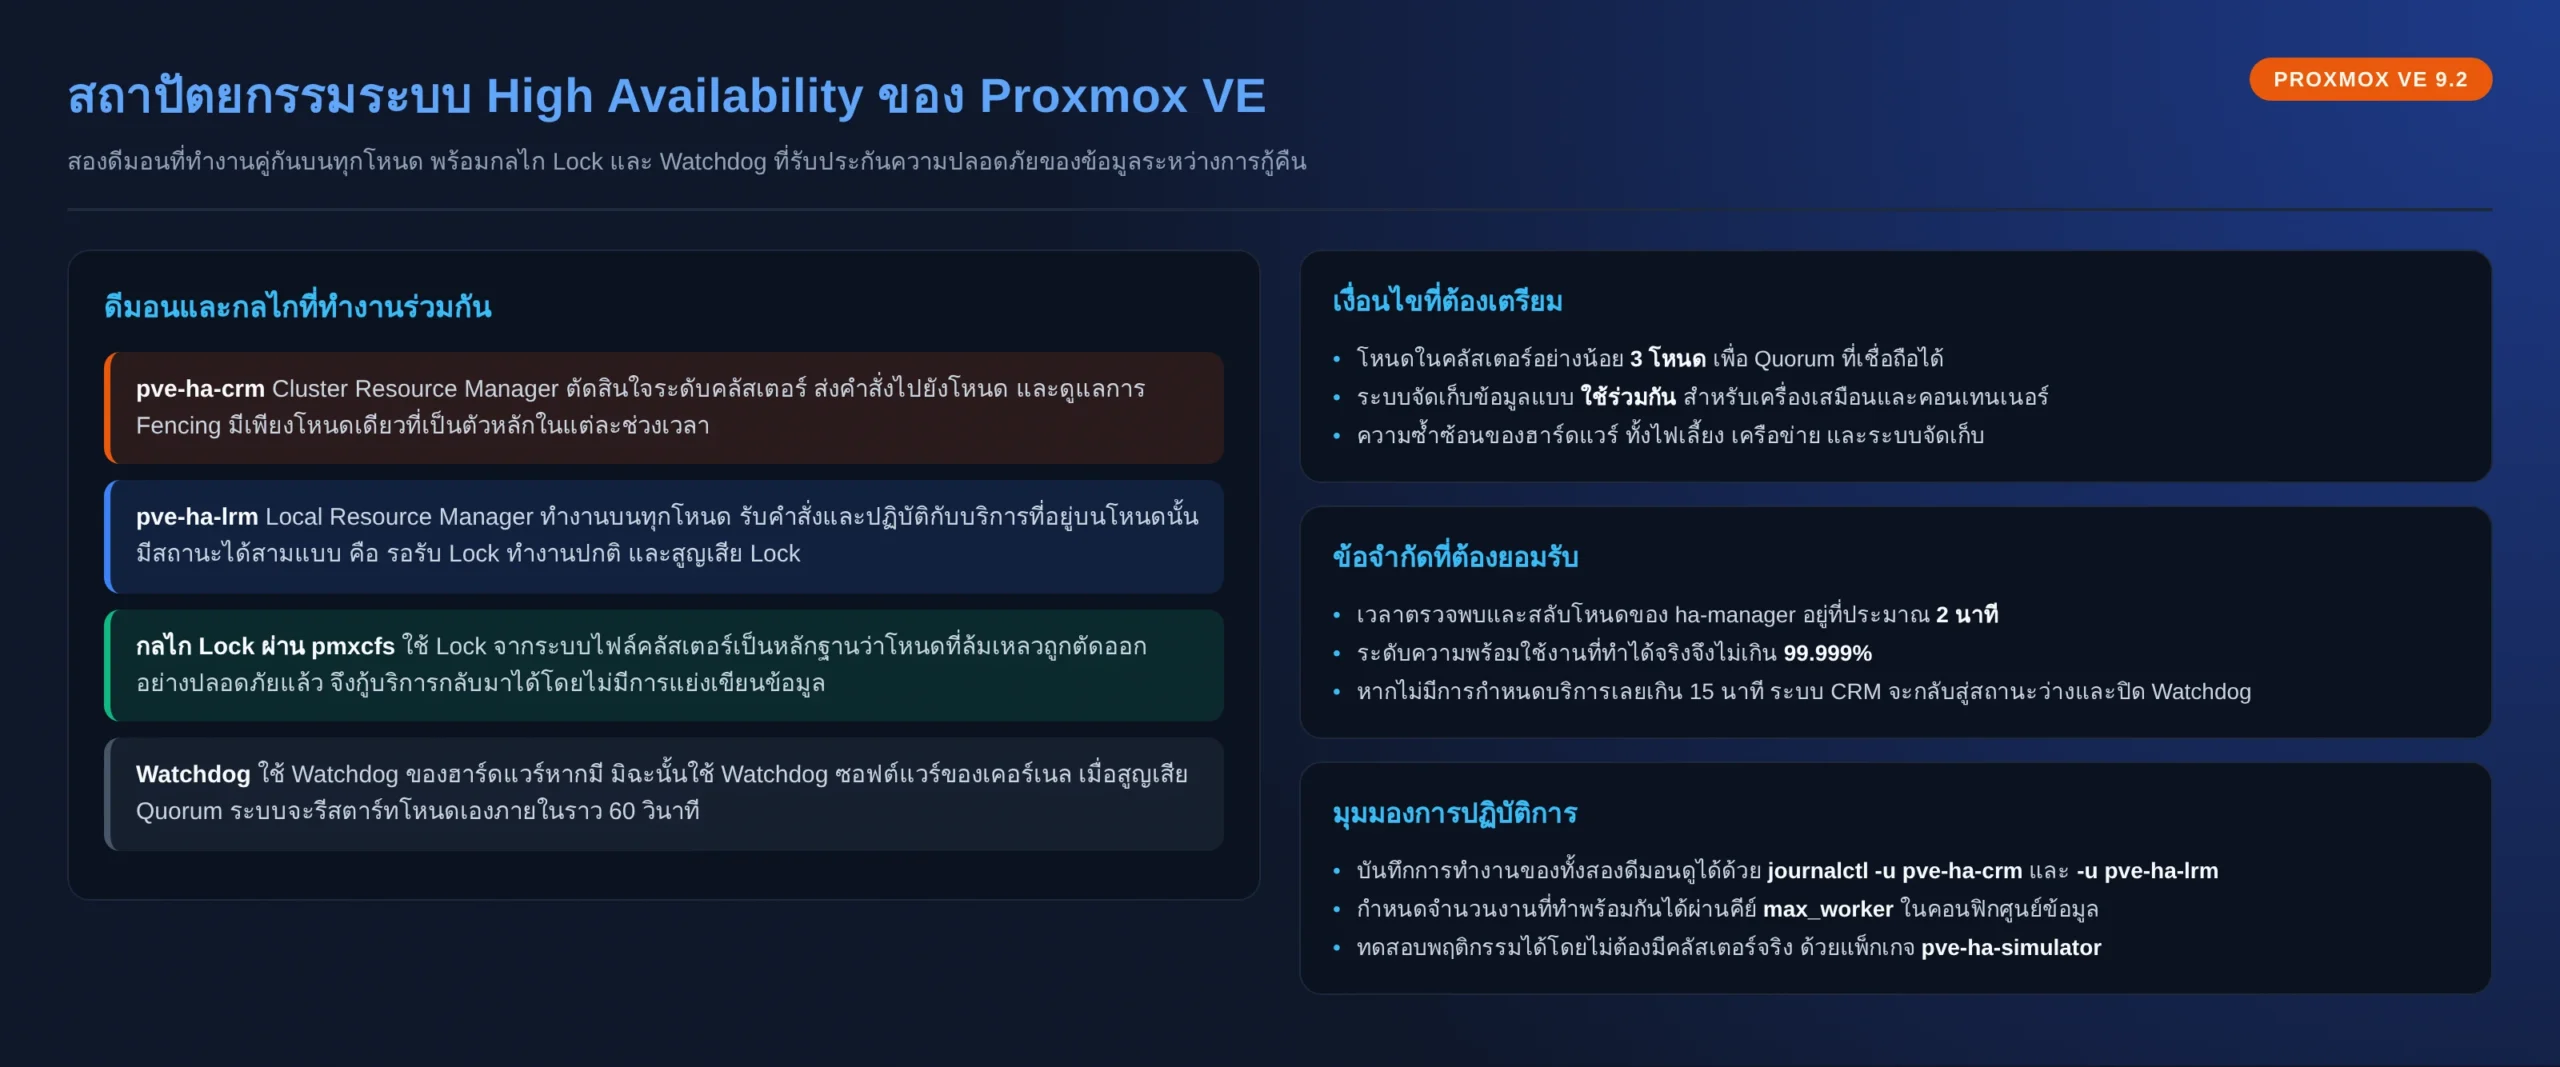
- pve-ha-crm (Cluster Resource Manager): ตัดสินใจระดับคลัสเตอร์ ส่งคำสั่งไปยังโหนดต่าง ๆ และดูแลเรื่อง Fencing โดยมีเพียงโหนดเดียวเท่านั้นที่เป็น CRM หลักในแต่ละช่วงเวลา
- pve-ha-lrm (Local Resource Manager): ทำงานบนทุกโหนด รับคำสั่งจาก CRM และลงมือปฏิบัติกับบริการที่อยู่บนโหนดนั้น
- กลไก Lock: ใช้ Lock จากระบบไฟล์คลัสเตอร์เป็นตัวรับประกันว่าโหนดที่ยึด Lock ของโหนดที่ล้มเหลวได้ จะถือว่าโหนดนั้นถูก Fence แล้ว และสามารถกู้บริการกลับมาได้อย่างปลอดภัย
2. เงื่อนไขที่ต้องเตรียมก่อนเปิดใช้งาน
- โหนดในคลัสเตอร์อย่างน้อย 3 โหนด เพื่อให้ได้ Quorum ที่เชื่อถือได้
- ระบบจัดเก็บข้อมูลแบบใช้ร่วมกัน สำหรับเครื่องเสมือนและคอนเทนเนอร์
- ความซ้ำซ้อนของฮาร์ดแวร์ ทั้งระบบไฟล์ เครือข่าย และระบบสำรองไฟ
- Watchdog: หากมีอุปกรณ์ Watchdog ในฮาร์ดแวร์จะใช้ตัวนั้น มิฉะนั้นระบบจะใช้ Watchdog ซอฟต์แวร์ของเคอร์เนลลินุกซ์แทน
ข้อเท็จจริงที่ต้องเข้าใจเรื่องระดับความพร้อมใช้งาน: เอกสารทางการระบุว่า ha-manager ใช้เวลาตรวจพบความผิดพลาดและสลับโหนดประมาณ 2 นาที ระดับความพร้อมใช้งานที่ทำได้จริงจึงอยู่ที่ไม่เกินร้อยละ 99.999 หรือคิดเป็นเวลาหยุดชะงักสูงสุดราว 5 นาทีต่อปี ซึ่งไม่ควรนำไปเปรียบเทียบกับระบบที่ออกแบบให้ทำงานพร้อมกันหลายชุดในระดับแอปพลิเคชัน
ขั้นตอนการตั้งค่า HA Cluster
ขั้นที่ 1: ตรวจสอบความพร้อมของทรัพยากรก่อนเพิ่มเข้า HA
ตามค่าเริ่มต้น ระบบถือว่าทุกโหนดในคลัสเตอร์เป็นโหนดที่สามารถรับงานได้ เพื่อให้เป็นเช่นนั้น ทรัพยากรแต่ละรายการควรใช้อุปกรณ์จัดเก็บข้อมูลที่ทุกโหนดเข้าถึงได้ ใช้อินเทอร์เฟซเครือข่ายที่มีอยู่บนทุกโหนด และไม่ผูกกับอุปกรณ์ส่งผ่านเฉพาะเครื่อง หากทรัพยากรมีข้อจำกัดเหล่านี้ ต้องกำหนดกฎการจำกัดโหนด (Node Affinity Rule) ให้ชัดเจน
ขั้นที่ 2: เพิ่มทรัพยากรเข้าสู่ระบบ HA
ทรัพยากรที่ HA ดูแลอยู่มีสองประเภทคือเครื่องเสมือนและคอนเทนเนอร์ โดยระบุเป็นรหัสบริการ เช่น vm:100 หรือ ct:101 การเพิ่มทรัพยากรทำได้ทั้งผ่านเว็บอินเทอร์เฟซและบรรทัดคำสั่ง
# เพิ่มเครื่องเสมือนรหัส 100 เข้าสู่ระบบ HA
ha-manager add vm:100

# กำหนดสถานะที่ต้องการให้ระบบดูแล
ha-manager set vm:100 --state started
ha-manager set vm:100 --state stopped

# ดูคอนฟิกและสถานะปัจจุบัน
ha-manager config
ha-manager status
คำสั่งจัดการเครื่องเสมือนตามปกติ เช่น การสั่งเปิดหรือปิด จะถูกส่งต่อไปยังระบบ HA โดยอัตโนมัติ กล่าวคือ การสั่งเปิดเครื่องเสมือนเพียงเปลี่ยนสถานะที่ระบบต้องการให้เป็น started และเนื่องจากระบบ HA ทำงานแบบไม่ประสานเวลา จึงต้องรอหลายวินาทีก่อนจะเห็นผลลัพธ์ที่ปลายทาง
ขั้นที่ 3: ปรับพารามิเตอร์ของทรัพยากร
ค่าที่สำคัญที่สุดในการควบคุมพฤติกรรมการกู้คืนคือจำนวนครั้งที่ยอมให้ลองใหม่หรือย้ายโหนด ค่าเหล่านี้เขียนไว้ในไฟล์ /etc/pve/ha/resources.cfg และปรับได้จากทั้งเว็บอินเทอร์เฟซและบรรทัดคำสั่ง
| พารามิเตอร์ | ค่าเริ่มต้น | ความหมายตามเอกสารทางการ |
|---|---|---|
| max_restart | 1 | จำนวนครั้งสูงสุดที่ยอมให้ลองเริ่มทรัพยากรใหม่บนโหนดเดิม เมื่อครบแล้วระบบจึงพิจารณาย้ายไปโหนดอื่น |
| max_relocate | 1 | จำนวนครั้งสูงสุดที่ยอมให้ย้ายทรัพยากรเมื่อเริ่มทำงานไม่สำเร็จ |
| failback | 1 | ย้ายทรัพยากรกลับไปยังโหนดที่มีลำดับความสำคัญสูงสุดตามกฎการจำกัดโหนด เมื่อโหนดนั้นกลับมาออนไลน์ |
| auto-rebalance | 1 | อนุญาตให้ระบบย้ายทรัพยากรเพื่อปรับสมดุลโดยอัตโนมัติ |
| group | – | ชื่อกลุ่ม HA ที่ทรัพยากรนี้สังกัด |
| state | – | สถานะที่ระบบต้องการให้เป็น ได้แก่ started, stopped, disabled, ignored |
ขั้นที่ 4: ทดสอบและตรวจสอบการทำงาน
การทดสอบย้ายทรัพยากรระหว่างโหนดทำได้สองวิธี โดยวิธีแรกจะย้ายแบบออนไลน์ซึ่งคงสถานะการทำงานไว้ แต่ต้องส่งข้อมูลหน่วยความจำทั้งหมดผ่านเครือข่าย ส่วนวิธีที่สองจะหยุดแล้วเริ่มใหม่บนโหนดปลายทาง
# ย้ายแบบออนไลน์ (คงสถานะการทำงานไว้)
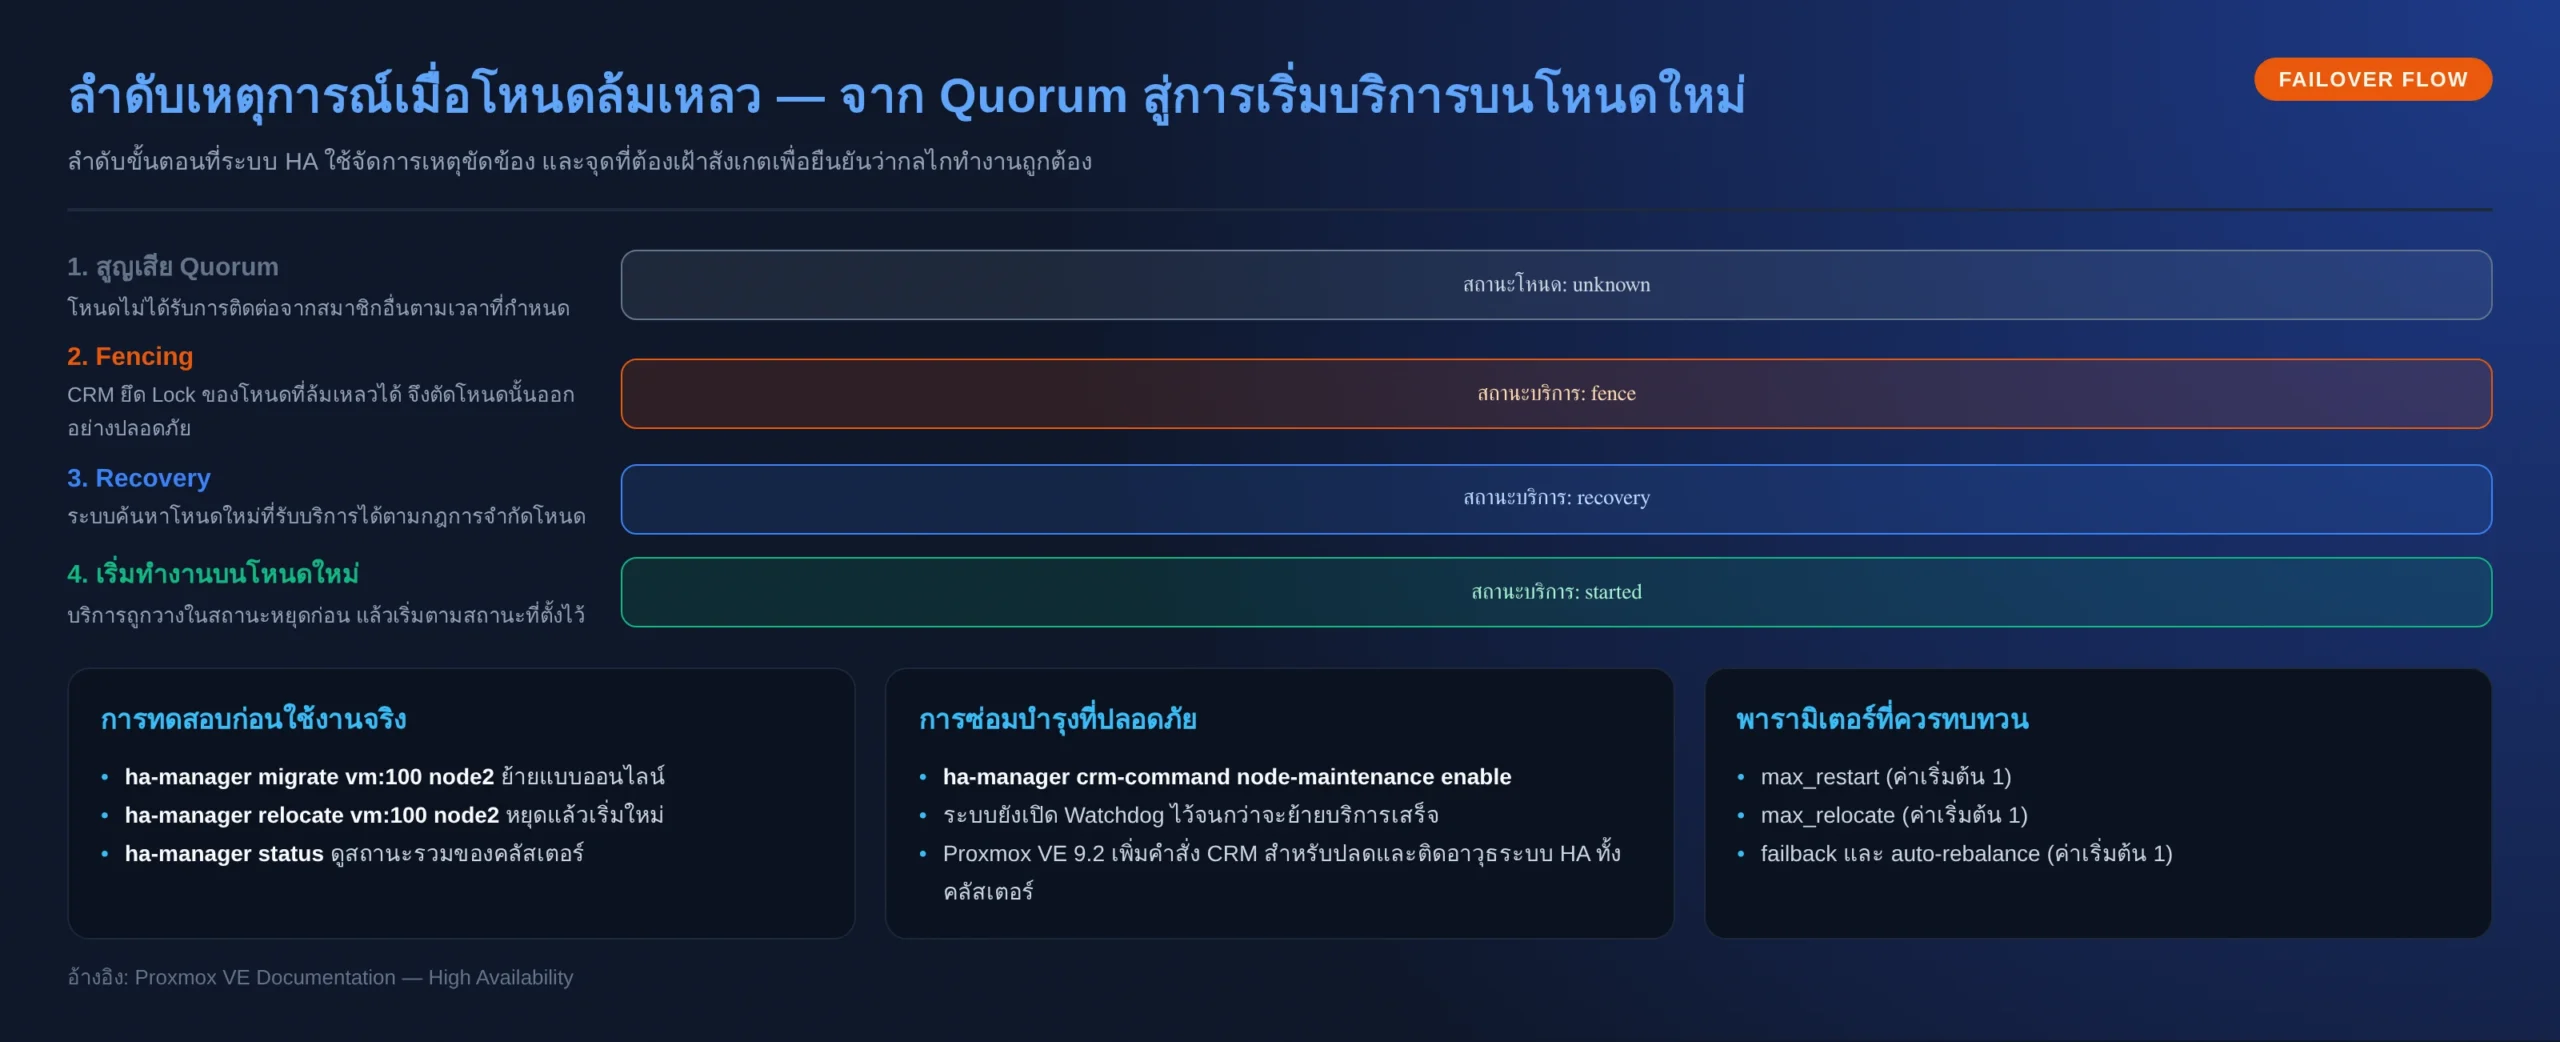
ha-manager migrate vm:100 node2

# ย้ายแบบหยุดแล้วเริ่มใหม่บนโหนดปลายทาง
ha-manager relocate vm:100 node2

# สอบถามสถานะของระบบ HA และทรัพยากร
ha-manager status

# ตรวจสอบบันทึกการทำงานของดีมอนทั้งสองตัว
journalctl -u pve-ha-crm
journalctl -u pve-ha-lrm
ขั้นที่ 5: การซ่อมบำรุงโดยไม่ให้เกิด Failover ที่ไม่ตั้งใจ
ก่อนปิดโหนดเพื่อซ่อมบำรุง ควรสั่งให้โหนดนั้นเข้าสู่โหมด Maintenance โดยระบบจะย้ายบริการที่ทำงานอยู่ออกไปก่อน และยังคงเปิด Watchdog ไว้จนกว่าจะย้ายเสร็จทั้งหมด เพื่อป้องกันไม่ให้ Watchdog ตัดการทำงานกลางทาง
# เปิดโหมดบำรุงรักษาให้โหนด
ha-manager crm-command node-maintenance enable node2

# ปิดโหมดบำรุงรักษา เพื่อให้บริการย้ายกลับ
ha-manager crm-command node-maintenance disable node2
สำหรับการซ่อมบำรุงที่กระทบทั้งคลัสเตอร์ เช่น การปรับเปลี่ยนโครงข่ายคลัสเตอร์ Proxmox VE 9.2 เพิ่มคำสั่ง CRM สำหรับปลดและติดอาวุธระบบ HA ทั้งคลัสเตอร์ ได้แก่คำสั่ง disarm-ha และ arm-ha ซึ่งช่วยให้ทำงานซ่อมบำรุงได้โดยไม่ทำให้เกิดเหตุ Fencing ที่ไม่ตั้งใจ และสถานะของทรัพยากรจะถูกเก็บไว้เพื่อกลับมาทำงานต่อตามเดิมเมื่อเสร็จสิ้น
ก่อนนำไปใช้กับระบบจริง แนะนำให้ทดลองพฤติกรรมของระบบ HA ในสภาพแวดล้อมจำลองที่ Proxmox VE จัดเตรียมไว้ให้ ซึ่งไม่ต้องใช้คลัสเตอร์จริงเลย
# ติดตั้งเครื่องมือจำลอง HA
apt install pve-ha-simulator

# สร้างไดเรกทอรีสำหรับเก็บสถานะการจำลอง แล้วเริ่มโปรแกรม
mkdir working
pve-ha-simulator working/
ลำดับเหตุการณ์เมื่อโหนดล้มเหลว
การทำความเข้าใจลำดับขั้นตอนช่วยให้คาดการณ์เวลาและผลกระทบได้ถูกต้อง และช่วยแยกแยะได้ว่าปัญหาที่เกิดขึ้นเป็นเรื่องปกติของกลไกหรือเป็นความผิดพลาดของคอนฟิก
- ตรวจพบว่าสูญเสีย Quorum: โหนดที่เป็นสมาชิกไม่ได้รับการติดต่อจากโหนดอื่นตามเวลาที่กำหนด สถานะของโหนดนั้นจะกลายเป็นสถานะไม่ทราบค่า
- Fencing: หาก CRM ยังคงยึด Lock ของโหนดที่ล้มเหลวได้ ระบบจะถือว่าโหนดนั้นถูกตัดออกจากการใช้งานอย่างปลอดภัย บริการที่อยู่บนโหนดนั้นจะเข้าสู่สถานะรอการกู้คืน
- Recovery: ระบบค้นหาโหนดใหม่ที่สามารถรับบริการได้ โดยพิจารณาจากรายชื่อโหนดที่ออนไลน์และอยู่ในกลุ่ม Quorum รวมถึงกฎการจำกัดโหนด
- เริ่มทำงานบนโหนดใหม่: บริการถูกย้ายไปยังโหนดที่เลือก โดยเริ่มจากสถานะหยุดก่อน แล้วจึงเริ่มทำงานตามสถานะที่ตั้งไว้
ความปลอดภัยเชิงระบบ: หากโหนดสูญเสีย Quorum และยังมีบริการที่ทำงานอยู่ ระบบจะไม่สามารถรีเซ็ต Watchdog ได้ และ Watchdog จะสั่งให้โหนดรีสตาร์ทตัวเองภายในประมาณ 60 วินาที กลไกนี้คือหัวใจของการป้องกันไม่ให้สองโหนดกลับมาเขียนข้อมูลลงอุปกรณ์จัดเก็บเดียวกันพร้อมกัน
ผลลัพธ์และประโยชน์
- ลดเวลาที่ระบบหยุดชะงัก: บริการสำคัญกลับมาทำงานได้เองโดยไม่ต้องรอผู้ดูแลระบบตื่นมารับเหตุ
- ซ่อมบำรุงได้ตามแผน: ย้ายงานออกจากโหนดที่ต้องปิดปรับปรุงได้ล่วงหน้าอย่างเป็นระบบ
- ป้องกันความเสียหายของข้อมูล: กลไก Fencing และ Watchdog ตัดโหนดที่ถูกแยกออกจากคลัสเตอร์ก่อนที่จะกลับมาแย่งใช้ข้อมูลร่วมกัน
- ตรวจสอบย้อนหลังได้: ทุกเหตุการณ์ถูกบันทึกไว้ในบันทึกของ CRM และ LRM ทำให้วิเคราะห์สาเหตุได้แม่นยำ
จุดเด่นของเรา
- ทดสอบ Failover ต่อหน้าลูกค้า: เราจำลองเหตุเครื่องดับและตัดเครือข่ายจริง เพื่อยืนยันว่าเวลาที่ระบบสลับโหนดสอดคล้องกับข้อกำหนดทางธุรกิจ
- วางแผนระบบจัดเก็บให้รองรับ HA: ออกแบบสตอเรจแบบใช้ร่วมกันหรือสตอเรจแบบกระจายให้ทุกโหนดเข้าถึงข้อมูลได้ เพื่อให้กลไก HA ทำงานได้จริง
- ป้องกัน Quorum Loss ล่วงหน้า: ตรวจสอบโครงข่ายคลัสเตอร์และเวลาตอบสนองระหว่างโหนด ก่อนเปิดใช้ในระบบผลิตจริง
- ส่งมอบคู่มือรับเหตุ: จัดทำขั้นตอนปฏิบัติเมื่อเกิดเหตุและรายการคำสั่งที่ต้องใช้ สำหรับทีมไอทีขององค์กรโดยเฉพาะ
ต้องการยกระดับความพร้อมใช้งานของระบบเสมือนในองค์กรหรือไม่
หากองค์กรของคุณต้องการลดเวลาหยุดชะงักจากเหตุฮาร์ดแวร์ หรือกำลังประเมินว่าโครงสร้างปัจจุบันสามารถรองรับ High Availability บน Proxmox Virtual Environment ได้หรือไม่ ทีมวิศวกรของเราพร้อมร่วมตรวจสอบและออกแบบแนวทางที่เหมาะสมกับข้อกำหนดของท่าน