Proxmox VE Hyperconverged Ceph Storage Fabric และการออกแบบ Pool ประสิทธิภาพสูง
คู่มือปฏิบัติการติดตั้งและตั้งค่า Ceph แบบ Hyperconverged บน Proxmox VE 9.2 ตั้งแต่การวางแผนทรัพยากร CPU หน่วยความจำ และเครือข่าย การสร้าง Monitor, Manager และ OSD ไปจนถึงการออกแบบ Pool ประสิทธิภาพสูงด้วย Device Class และ CRUSH Rule
ปัญหาและโจทย์
การลงทุนระบบเสมือนจริงในองค์กรโดยทั่วไป มักมีสัดส่วนค่าใช้จ่ายของระบบจัดเก็บข้อมูลกลาง (Storage Area Network) สูงกว่าส่วนประมวลผลอย่างชัดเจน ทั้งค่าอุปกรณ์สตอเรจ ค่าลิขสิทธิ์ และค่าบำรุงรักษารายปี ทำให้ต้นทุนต่อเครื่องเสมือนหนึ่งเครื่องสูงกว่าที่ควร
อีกด้านหนึ่ง องค์กรจำนวนมากมีดิสก์ความจุสูงติดตั้งอยู่ในเครื่องเซิร์ฟเวอร์แล้ว แต่ไม่สามารถนำพื้นที่ว่างเหล่านั้นมาใช้ร่วมกันได้ เพราะถูกจำกัดไว้ใน RAID ท้องถิ่นของแต่ละเครื่อง ส่งผลให้เกิดทั้งพื้นที่เหลือทิ้งและคอขวดด้านประสิทธิภาพในเวลาเดียวกัน
ความท้าทายจึงไม่ใช่เพียงการหาพื้นที่จัดเก็บให้เพียงพอ แต่เป็นการออกแบบระบบจัดเก็บแบบกระจายที่ทำงานร่วมกับระบบประมวลผลบนฮาร์ดแวร์ชุดเดียวกันได้อย่างมีเสถียรภาพ โดยไม่ทำให้ทราฟฟิกสตอเรจไปรบกวนการทำงานของคลัสเตอร์
แนวทางการแก้ปัญหา: รวม Compute และ Storage เป็นระบบเดียว
Ceph เป็นแพลตฟอร์มจัดเก็บข้อมูลแบบกระจายที่ Proxmox VE ผสานรวมไว้ในตัว เมื่อติดตั้งบนโหนดของคลัสเตอร์เดียวกัน ระบบจะทำหน้าที่เป็น Hyperconverged Appliance ที่ให้ทั้งความจุ การทำสำเนาข้อมูล และการทำงานต่อเนื่องได้ในชุดเดียว
1. บริการหลักในคลัสเตอร์ Ceph
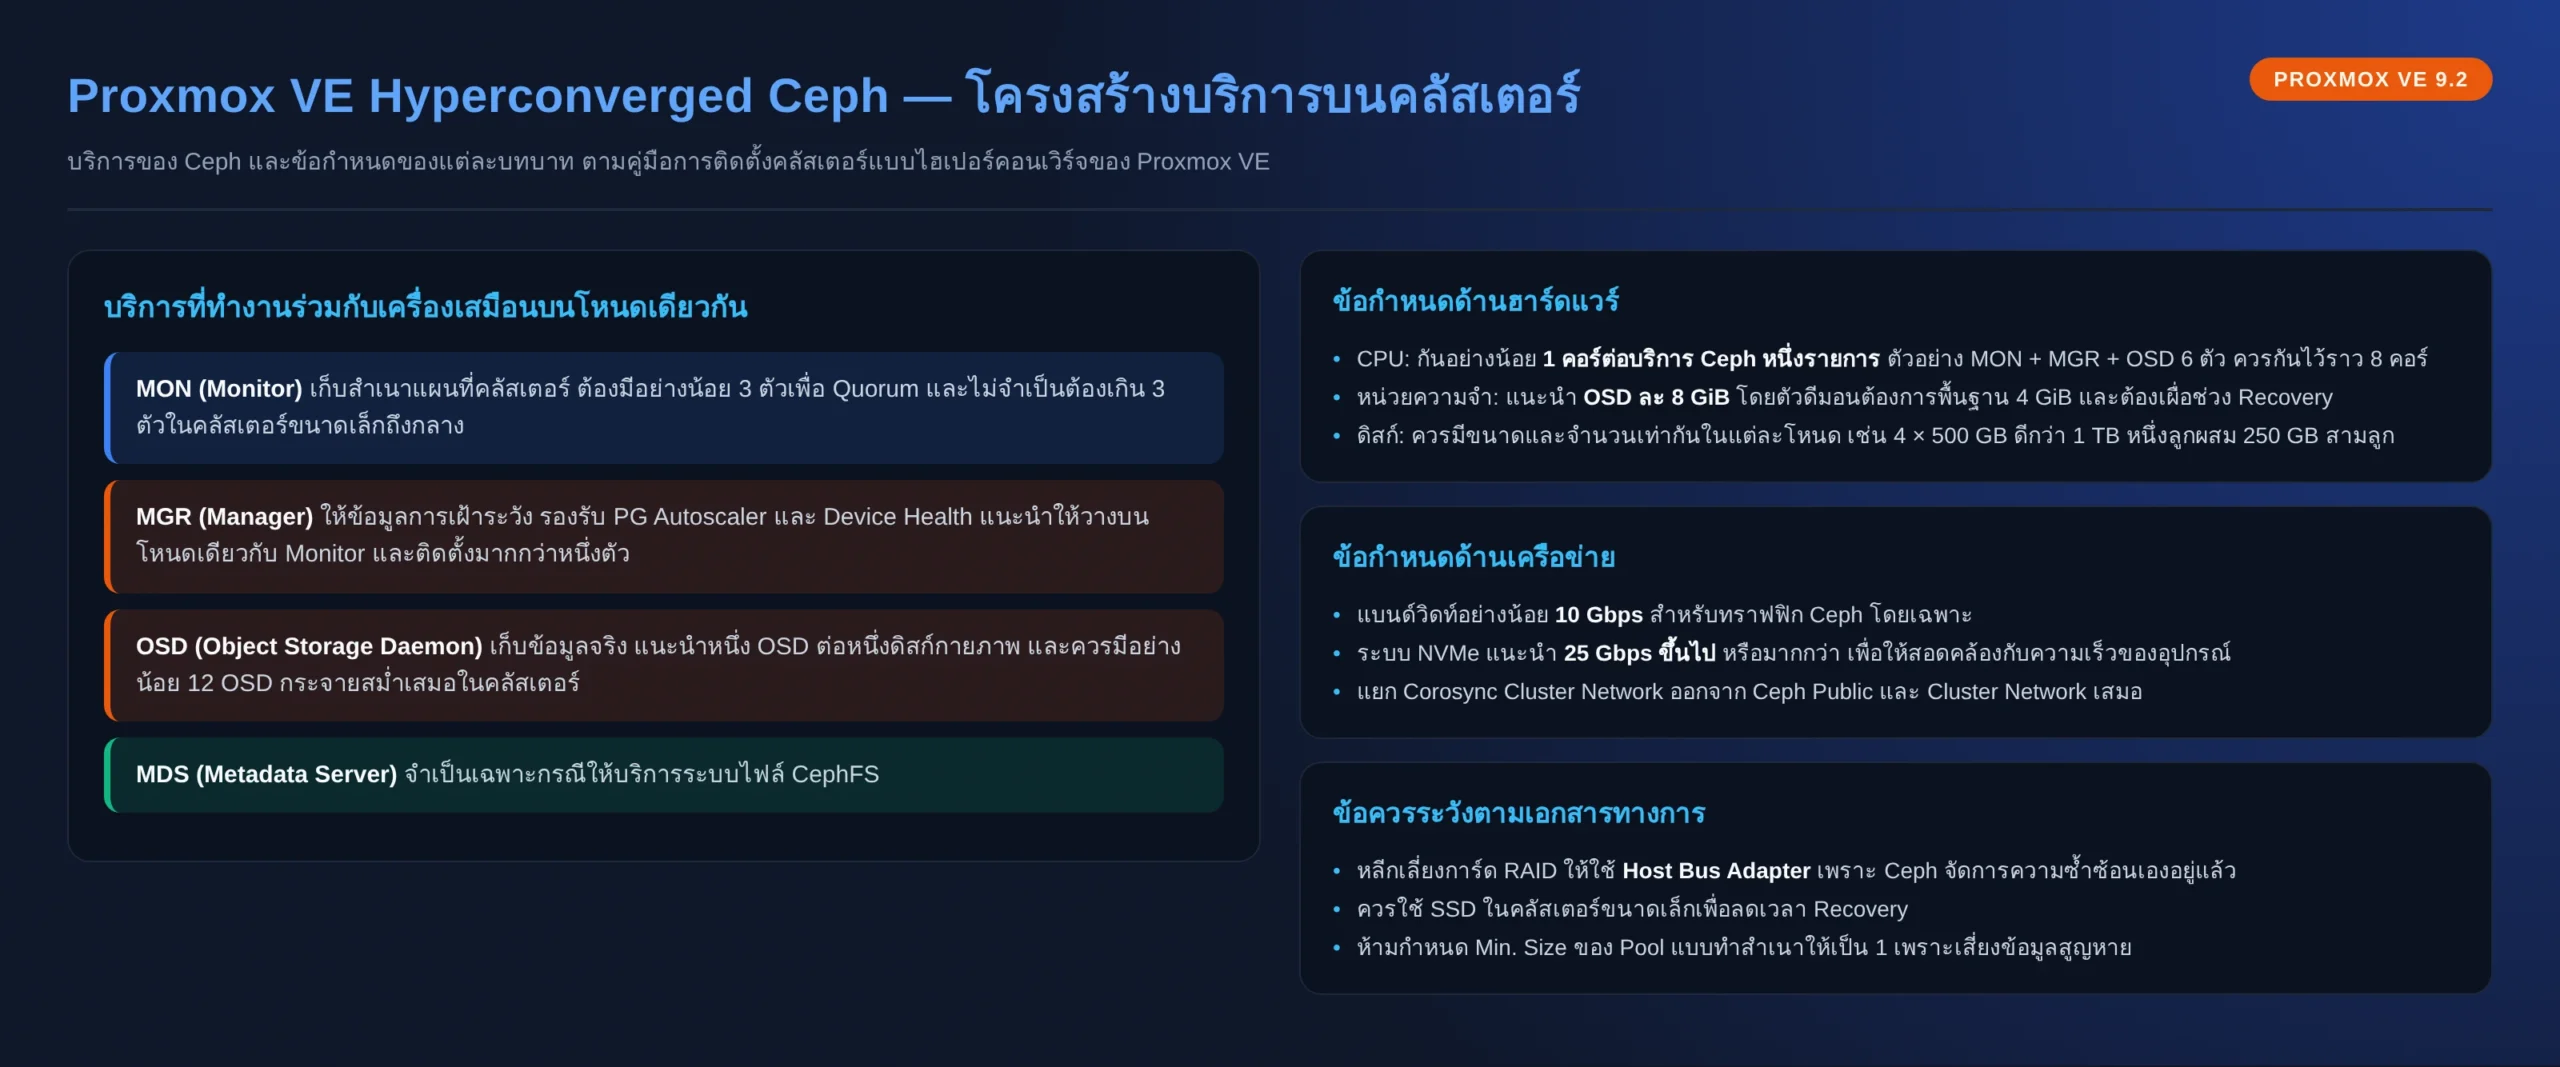
- Monitor (MON): เก็บสำเนาแผนที่คลัสเตอร์ ต้องมีอย่างน้อย 3 ตัวเพื่อ Quorum
- Manager (MGR): ให้ข้อมูลการเฝ้าระวังและดูแลกลไกสำคัญ เช่น PG Autoscaler และ Device Health
- Object Storage Daemon (OSD): เก็บข้อมูลจริง แนะนำหนึ่ง OSD ต่อหนึ่งดิสก์กายภาพ
- Metadata Server (MDS): จำเป็นเฉพาะเมื่อให้บริการระบบไฟล์ CephFS
2. ข้อดีที่ได้จากโมเดลนี้
- ไม่ต้องพึ่งผู้ผลิตสตอเรจรายเดียว: ทำงานบนฮาร์ดแวร์ทั่วไปได้ และไม่จำเป็นต้องใช้การ์ด RAID
- Thin Provisioning และ Snapshot: จัดสรรพื้นที่ตามการใช้งานจริง
- Self-Healing: ระบบทำสำเนาข้อมูลคืนสูสภาพที่ถูกต้องได้เองเมื่อดิสก์เสีย
- แยกชั้นประสิทธิภาพได้: กำหนด Pool แยกตามชนิดดิสก์เพื่อกำหนดคุณลักษณะด้านความเร็วและความทนทาน
เวอร์ชันที่อ้างอิงในคู่มือนี้: Proxmox VE 9.2 ใช้ระบบฐาน Debian 13 “Trixie” และเคอร์เนล 7.0 เป็นค่าเริ่มต้น โดยมี Ceph Tentacle 20.2.3 เป็นรุ่นเสถียรเริ่มต้น และยังคงมี Ceph Squid 19.2.3 ให้เลือกใช้หากต้องการความเข้ากันได้กับระบบเดิม
ขั้นตอนการตั้งค่า Ceph แบบ Hyperconverged
ขั้นที่ 1: วางแผนทรัพยากรก่อนติดตั้ง
เอกสารทางการระบุว่า การสร้างคลัสเตอร์ Proxmox VE ที่ทำงานร่วมกับ Ceph ควรใช้เซิร์ฟเวอร์อย่างน้อย 3 เครื่องที่มีสเปกใกล้เคียงกัน และแนะนำให้มี OSD อย่างน้อย 12 ตัวกระจายอย่างสม่ำเสมอในแต่ละโหนด การวางแผนที่ต้องทำให้ชัดเจนมีดังนี้
| ทรัพยากร | แนวทางจากเอกสารทางการ |
|---|---|
| CPU | กำหนดอย่างน้อย 1 คอร์หรือ 1 เธรดต่อบริการ Ceph หนึ่งรายการ ตัวอย่างเช่น โหนดที่มี MON 1 ตัว, MGR 1 ตัว และ OSD 6 ตัว ควรกันทรัพยากรไว้ราว 8 คอร์ |
| หน่วยความจำ | ค่าแนะนำคือกำหนดให้ OSD ใช้หน่วยความจำอย่างน้อย 8 GiB เพื่อประสิทธิภาพที่ดี โดยตัว OSD เองมีความต้องการพื้นฐานที่ 4 GiB และต้องเผื่อหน่วยความจำส่วนเกินสำหรับช่วง Recovery หรือ Rebalancing |
| เครือข่าย | แนะนำอย่างน้อย 10 Gbps สำหรับทราฟฟิก Ceph โดยเฉพาะ และควรเป็น 25 Gbps ขึ้นไปเมื่อใช้ NVMe |
| ตัวควบคุมดิสก์ | หลีกเลี่ยงการ์ด RAID และใช้ Host Bus Adapter แทน เนื่องจาก Ceph จัดการความซ้ำซ้อนของข้อมูลได้เอง |
ค่าหน่วยความจำของ OSD สามารถปรับผ่านคอนฟิกของ Ceph ได้โดยตรงดังนี้
# ตั้งเป้าหมายหน่วยความจำของ OSD ทุกตัวในคลัสเตอร์
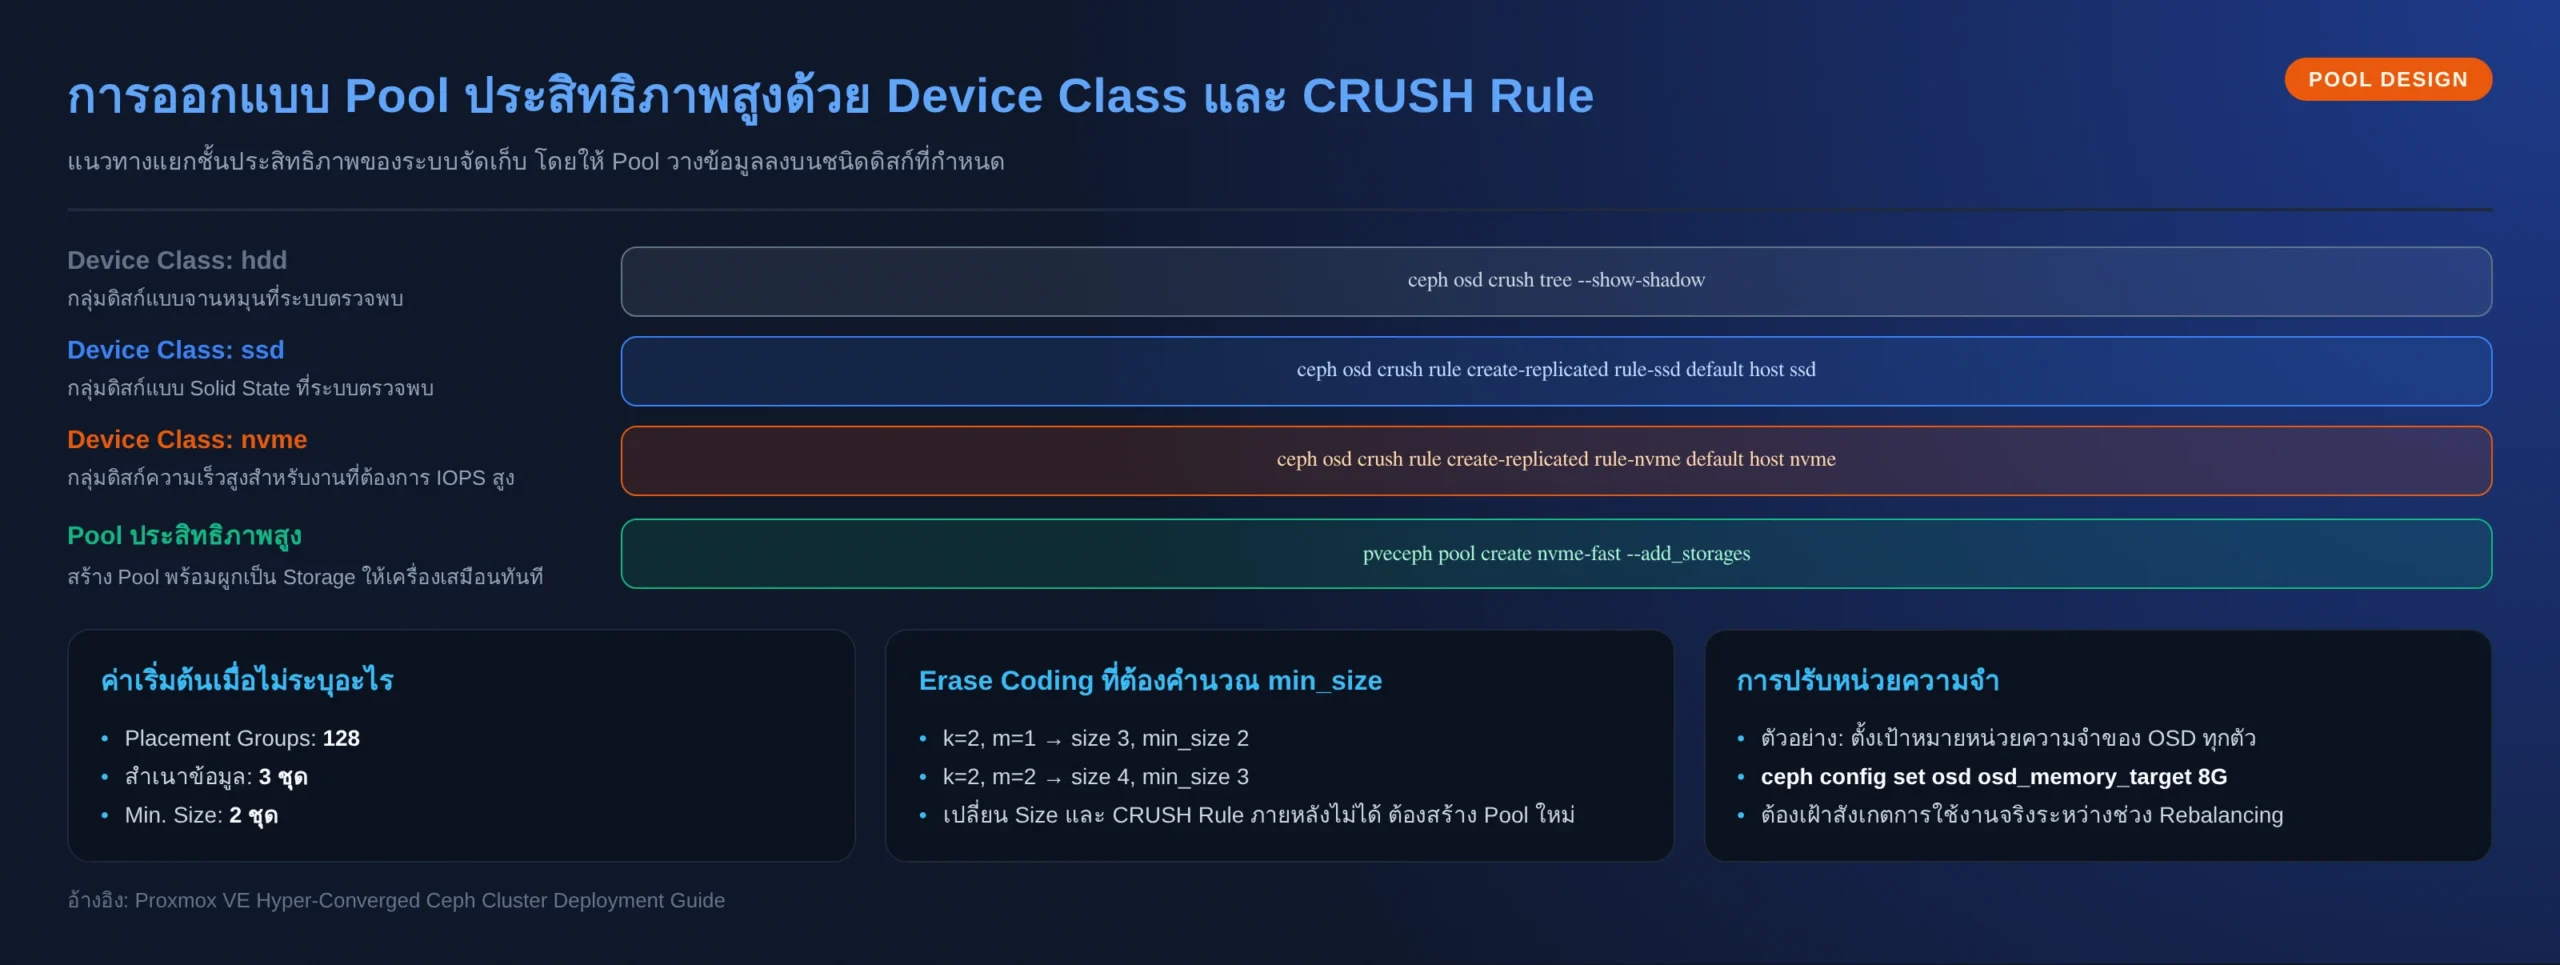
ceph config set osd osd_memory_target 8G
ขั้นที่ 2: ติดตั้งแพ็กเกจ Ceph และสร้างคอนฟิกเริ่มต้น
สามารถใช้ตัวช่วยติดตั้งผ่านเว็บอินเทอร์เฟซได้โดยตรง หรือติดตั้งผ่านบรรทัดคำสั่งบนทุกโหนด จากนั้นสร้างคอนฟิกเริ่มต้นเพียงครั้งเดียว โดยระบุเครือข่ายที่จะใช้สำหรับ Ceph
# รันบนทุกโหนดในคลัสเตอร์
pveceph install

# รันเพียงโหนดเดียวเพื่อสร้างคอนฟิกเริ่มต้น
pveceph init --network 10.10.10.0/24
คำสั่งนี้จะสร้างไฟล์คอนฟิกที่ /etc/pve/ceph.conf พร้อมลิงก์ที่ /etc/ceph/ceph.conf ทำให้เรียกใช้คำสั่งของ Ceph ได้ทันทีโดยไม่ต้องระบุพาธคอนฟิก และเนื่องจากไฟล์อยู่ในระบบไฟล์คลัสเตอร์ คอนฟิกจึงถูกกระจายไปทุกโหนดโดยอัตโนมัติ
ขั้นที่ 3: สร้าง Monitor และ Manager
สร้าง Monitor ให้ครบ 3 ตัวเพื่อให้มี Quorum โดยโหนดที่เลือกสร้างตัวช่วยติดตั้งจะได้ Monitor ตัวแรกมาแล้ว สำหรับ Manager แนะนำให้ติดตั้งบนโหนดเดียวกับ Monitor และติดตั้งมากกว่าหนึ่งตัวเพื่อความพร้อมใช้งาน
# รันบนโหนดที่ต้องการวาง Monitor (แนะนำ 3 โหนด)
pveceph mon create

# สร้าง Manager
pveceph mgr create
ขั้นที่ 4: สร้าง OSD จากดิสก์
ตรวจสอบชื่ออุปกรณ์ดิสก์ให้แน่ชัดก่อนสร้าง OSD ทุกครั้ง หากดิสก์เคยถูกใช้งานมาก่อน ต้องล้างข้อมูลเดิมออกก่อนด้วยคำสั่ง zap ซึ่งเป็นคำสั่งที่ทำลายข้อมูลบนดิสก์ทั้งหมด
# ตรวจสอบดิสก์ที่พร้อมใช้งานก่อนเสมอ
lsblk -o NAME,SIZE,TYPE,MODEL

# ล้างข้อมูลเดิมบนดิสก์ (ข้อมูลจะสูญหายทั้งหมด)
ceph-volume lvm zap /dev/sdX --destroy

# สร้าง OSD
pveceph osd create /dev/sdX
ขั้นที่ 5: สร้าง Pool และกำหนดค่าสำหรับงานประสิทธิภาพสูง
หากไม่ระบุค่าใด ระบบจะกำหนดค่าเริ่มต้นที่ 128 Placement Groups, ทำสำเนา 3 ชุด และค่า Min. Size เท่ากับ 2 เพื่อให้ข้อมูลไม่สูญหายเมื่อ OSD ตัวใดตัวหนึ่งเสีย สำหรับ Pool ที่ต้องการความจุสูงขึ้นโดยแลกกับประสิทธิภาพ สามารถใช้ Erasure Coding ได้
# สร้าง Pool แบบทำสำเนา พร้อมสร้าง Storage ใน Proxmox VE ให้ทันที
pveceph pool create nvme-fast --add_storages

# สร้าง Pool แบบ Erasure Coding (k=2, m=1: ทนการเสียหาย 1 OSD)
pveceph pool create archive-ec --erasure-coding k=2,m=1

# สร้าง Pool แบบ EC โดยไม่สร้าง Storage อัตโนมัติ
pveceph pool create archive-ec-2 --erasure-coding k=2,m=1 --add_storages 0
การแยกชั้นประสิทธิภาพทำได้ด้วย Device Class โดย Ceph จะจัดกลุ่มดิสก์ตามชนิดโดยอัตโนมัติ จากนั้นสร้าง CRUSH Rule ที่ผูกกับ Device Class นั้น เพื่อให้ Pool วางข้อมูลลงบนสื่อที่ต้องการเท่านั้น
# ดู Device Class ที่ระบบตรวจพบ
ceph osd crush tree --show-shadow

# สร้าง CRUSH Rule ที่ผูกกับ Device Class ที่ต้องการ
ceph osd crush rule create-replicated rule-nvme default host nvme
ข้อควรระวังสำคัญ: เอกสารทางการระบุอย่างชัดเจนว่าห้ามกำหนดค่า Min. Size ของ Pool แบบทำสำเนาให้เป็น 1 เนื่องจากจะยอมให้อ่านและเขียนข้อมูลได้แม้เหลือสำเนาเพียงชุดเดียว ซึ่งเสี่ยงต่อการสูญหายของข้อมูลและอาจทำให้เกิด Placement Group ที่ไม่สมบูรณ์
ขอบเขตและศักยภาพบริการ: เปรียบเทียบรูปแบบ Pool
| หัวข้อเปรียบเทียบ | Replicated Pool (ค่าเริ่มต้น) | Erasure Coded Pool (k=2, m=1) | Erasure Coded Pool (k=2, m=2) |
|---|---|---|---|
| จำนวนสำเนา / โครงสร้าง | ทำสำเนา 3 ชุด (ปรับได้) | ข้อมูล 2 ส่วน + ส่วนตรวจสอบ 1 ส่วน | ข้อมูล 2 ส่วน + ส่วนตรวจสอบ 2 ส่วน |
| ค่า Size / Min. Size | Size 3 / Min. Size 2 | Size 3 / Min. Size 2 | Size 4 / Min. Size 3 |
| ความทนทานต่อการเสียหาย | ทนการเสียหายได้หลาย OSD ตามจำนวนสำเนา | ทำงานต่อได้เมื่อเสียหาย 1 OSD | ทำงานต่อได้เมื่อเสียหาย 1 OSD |
| ความคุ้มค่าด้านพื้นที่ | ใช้พื้นที่มากกว่า (สำเนาซ้ำ) | ใช้พื้นที่คุ้มค่ากว่าแบบทำสำเนา | คุ้มค่ากว่า แต่กินพื้นที่มากกว่าแบบ m=1 |
| ประสิทธิภาพ | เหมาะกับงานที่ต้องการ IOPS สูง | แลกประสิทธิภาพกับความจุ | แลกประสิทธิภาพมากกว่าเพื่อความทนทาน |
| การเปลี่ยนค่าในภายหลัง | ปรับ Size และ CRUSH Rule ได้ | เปลี่ยน Size และ CRUSH Rule ไม่ได้ ต้องสร้าง Pool ใหม่ | เปลี่ยน Size และ CRUSH Rule ไม่ได้ ต้องสร้าง Pool ใหม่ |
ผลลัพธ์และประโยชน์
- ใช้ฮาร์ดแวร์ให้คุ้มค่าที่สุด: นำดิสก์ท้องถิ่นมารวมเป็นสตอเรจกลางที่ทุกโหนดเข้าถึงได้ ลดความจำเป็นในการซื้อสตอเรจแยก
- กำหนดชั้นประสิทธิภาพได้ตามงาน: แยก Pool ตาม Device Class เพื่อให้งานที่ต้องการ IOPS สูงและงานที่ต้องการความจุสูงอยู่ร่วมกันได้
- ย้ายเครื่องเสมือนได้ทันที: ทุกโหนดมองเห็นข้อมูลชุดเดียวกัน จึงทำ Live Migration ได้โดยไม่ต้องคัดลอกดิสก์ข้ามเครือข่าย
- ขยายระบบได้เป็นขั้นบันได: เพิ่มโหนดหรือเพิ่ม OSD ได้ตามการเติบโต และระบบจะปรับสมดุลข้อมูลให้เอง
จุดเด่นของเรา
- คำนวณขนาดก่อนขาย: เราประเมินจำนวน OSD หน่วยความจำ และแบนด์วิดท์ที่ต้องใช้จริงจากข้อมูลภาระงานของท่าน เพื่อไม่ให้เกิดคอขวดหลังติดตั้ง
- ออกแบบ Pool ให้ตรงกับงาน: วางโครงสร้าง Device Class และ CRUSH Rule ให้สอดคล้องกับลักษณะข้อมูล ทั้งงานฐานข้อมูล งานไฟล์เซิร์ฟเวอร์ และงานสำรองข้อมูล
- ทดสอบความทนทานจริง: จำลองการถอดดิสก์ออกจากระบบระหว่างทำงาน เพื่อยืนยันว่าระบบฟื้นสภาพได้ตามที่ออกแบบ
- ส่งมอบพร้อมคู่มือปฏิบัติการ: เอกสารขั้นตอนเพิ่ม OSD เปลี่ยนดิสก์เสีย และการเฝ้าระวังสุขภาพคลัสเตอร์สำหรับทีมไอทีขององค์กร
ต้องการออกแบบระบบจัดเก็บแบบ Hyperconverged สำหรับองค์กรคุณหรือไม่
หากองค์กรของคุณกำลังพิจารณาลดภาระการลงทุนสตอเรจแยก หรือต้องการคำปรึกษาการออกแบบ Ceph Storage Fabric บน Proxmox Virtual Environment 9.2 ทั้งด้านจำนวน OSD เครือข่าย และการวาง Pool ทีมวิศวกรของเราพร้อมร่วมวิเคราะห์โครงสร้างปัจจุบันของท่าน