ในยุคที่ระบบปัญญาประดิษฐ์แบบเอเจนต์ (Agentic AI) ถูกนำไปใช้งานจริงในองค์กรอย่างรวดเร็ว คำถามสำคัญที่หลายองค์กรยังตอบไม่ได้คือ “เมื่อ AI เริ่มลงมือทำสิ่งต่าง ๆ ด้วยตัวเอง ความเสี่ยงด้านความปลอดภัยจะตามมาอย่างไร” บทความนี้เรียบเรียงจากแนวคิดของ K. Ashish Kumar และทีม Secure Debug ซึ่งชี้ให้เห็นว่าสถาปัตยกรรมของ AI Agent ไม่ได้เป็นเพียงเรื่องของโมเดลภาษาเท่านั้น แต่เป็นระบบที่ซับซ้อนซึ่งทุกองค์ประกอบล้วนขยายทั้งขีดความสามารถและพื้นผิวการโจมตีไปพร้อมกัน
สถาปัตยกรรม AI Agent: องค์ประกอบหลักที่ต้องรู้จัก
ก่อนจะเข้าใจความเสี่ยง จำเป็นต้องเข้าใจโครงสร้างของ AI Agent เสียก่อน ซึ่งประกอบด้วยองค์ประกอบสำคัญ 9 ประการที่ทำงานร่วมกันเป็นวงจร:
- Harness (ชุดควบคุมการทำงาน) — กลไกวนลูปที่ทำให้โมเดลภาษาขนาดใหญ่ (LLM) ลงมือกระทำจริง ไม่ใช่เพียงแค่ตอบข้อความ
- Memory & State (หน่วยความจำและสถานะ) — ความสามารถในการจดจำข้ามรอบการทำงาน และรับรู้ว่าตนเองอยู่ ณ จุดใดของงาน
- RAG (Retrieval-Augmented Generation) — กระบวนการดึงข้อมูล ฉีดเข้าบริบท แล้วจึงสร้างคำตอบ
- MCP (Model Context Protocol) — มาตรฐานเดียวสำหรับเชื่อมต่อเครื่องมือและแหล่งข้อมูล
- Skills (ชุดทักษะ) — ความรู้ที่นำกลับมาใช้ซ้ำได้ ถูกโหลดเมื่อต้องการใช้งาน
- Guardrails (ราวกั้น) — ขอบเขตที่จำกัดว่าเอเจนต์สามารถทำอะไรได้บ้าง
- Evals (การประเมินผล) — การให้คะแนนผลลัพธ์ก่อนส่งถึงผู้ใช้งานจริง
- A2A (Agent-to-Agent) — กลไกให้เอเจนต์สื่อสารกับเอเจนต์อื่น
- Multi-Agent System (ระบบหลายเอเจนต์) — ตัวประสานงาน (Orchestrator) ที่แบ่งงานให้เอเจนต์ย่อย
ความเสี่ยงด้านความปลอดภัยที่ขยายตัวตามสถาปัตยกรรม
ประเด็นสำคัญที่ Secure Debug เน้นย้ำคือ ทุกองค์ประกอบที่เพิ่มเข้ามาไม่ได้ขยายเพียงพื้นผิวการโจมตี (Attack Surface) แต่ยังขยาย “อำนาจในการกระทำ” ของระบบด้วย หน่วยความจำเป็นตัวกำหนดว่าสิ่งใดจะคงอยู่ต่อไป และขอบเขตอำนาจ (Authority Boundary) คือจุดที่ความปลอดภัยและความรับผิดทางกฎหมายมาบรรจบกัน
ความเสี่ยงหลักที่องค์กรต้องเฝ้าระวัง ได้แก่:
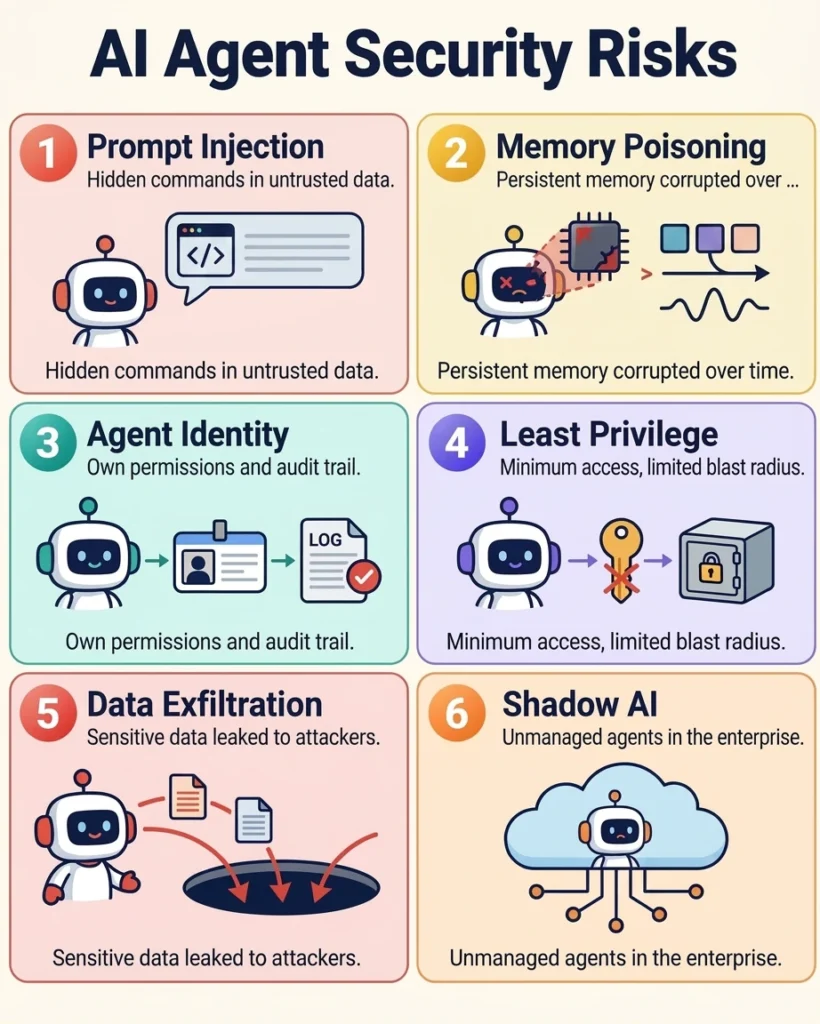
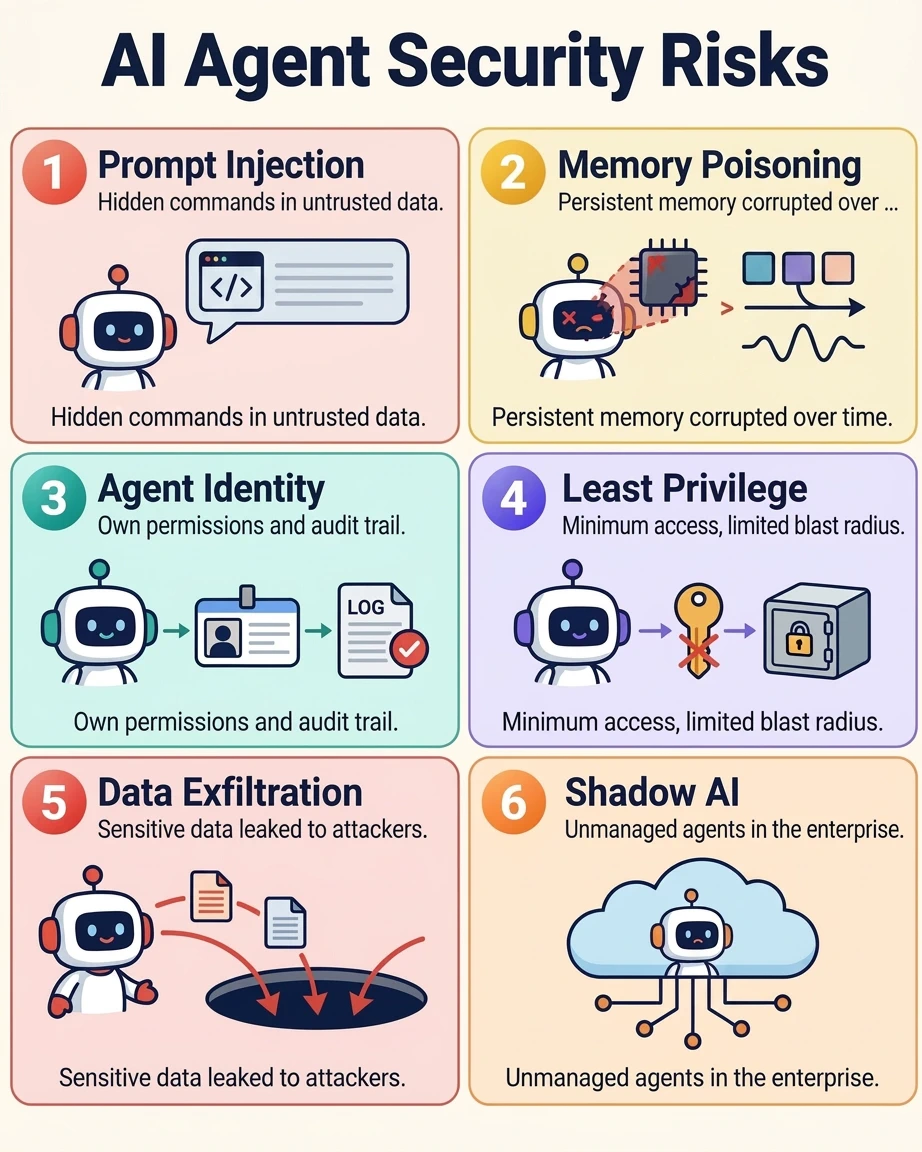
- Prompt Injection — คำสั่งอันตรายสามารถแฝงมากับอีเมล เอกสาร เว็บไซต์ หรือเนื้อหาที่ถูกดึงมา ไม่ใช่เพียงจากผู้ใช้โดยตรงเท่านั้น
- Memory Security — หน่วยความจำถาวรของเอเจนต์ หากไม่ถูกแยกส่วนอย่างเหมาะสม อาจนำไปสู่การรั่วไหลของข้อมูล หรือการวางยาพิษหน่วยความจำ (Memory Poisoning)
- Agent Identity — เอเจนต์ควรมีอัตลักษณ์ สิทธิ์ และบันทึกการตรวจสอบ (Audit Trail) เป็นของตนเอง ไม่ใช่สืบทอดสิทธิ์ของผู้ใช้คนใดคนหนึ่ง
- High-Impact Actions — การกระทำที่มีผลกระทบสูงต้องถูกควบคุมอย่างเข้มงวด เพราะ API ที่ปลอดภัยสมบูรณ์แบบ หากถูกเรียกโดยโมเดลที่ถูกโจมตีด้วย prompt injection ก็ยังนำไปสู่อุบัติเหตุด้านความปลอดภัยได้จริง
แนวคิด Agentic Darwinism และการออกแบบที่ยั่งยืน
บทความจาก OX Security ที่ถูกอ้างถึงในต้นฉบับ เรียกปรากฏการณ์นี้ว่า “Agentic Darwinism” — เอเจนต์ในปัจจุบันเป็นระบบเปลี่ยนผ่าน (Transitional Systems) เฟรมเวิร์ก โปรโตคอล และสถาปัตยกรรมที่เรากำลังรักษาความปลอดภัยในวันนี้ อาจเปลี่ยนโฉมหรือหายไปโดยสิ้นเชิงภายในไม่กี่ปี
ดังนั้น ทีมความปลอดภัยจึงควรสร้างการป้องกันรอบ “ขีดความสามารถ” (Capabilities) มากกว่า “การนำไปใช้งานเฉพาะ” (Implementations) โดยออกแบบสิทธิ์ของเอเจนต์ด้วยหลักการเดียวกับการออกแบบสิทธิ์เข้าถึงระบบงานจริง ได้แก่ สิทธิ์ขั้นต่ำที่จำเป็น (Least Privilege) ขอบเขตที่ชัดเจน การกระทำที่สังเกตได้ และรัศมีความเสียหายที่จำกัด (Limited Blast Radius)
แนวทางปฏิบัติสำหรับองค์กร
องค์กรที่เริ่มนำ AI Agent มาใช้ควรตอบคำถามเหล่านี้ให้ได้ก่อนขยายการใช้งาน:
- เราตรวจจับ prompt injection การรั่วไหลของข้อมูล คำสั่งอันตราย และ indirect prompt injection ผ่านเนื้อหาภายนอกได้อย่างไร
- การค้นพบสินทรัพย์ AI (AI Asset Discovery) ทั่วทั้งองค์กรมีหน้าตาอย่างไร
- เราสามารถระบุการใช้ AI แบบเงา (Shadow AI) ได้ก่อนที่ข้อมูลละเอียดอ่อนจะรั่วไหลไปยังที่ที่ไม่ควรหรือไม่
- จะเกิดอะไรขึ้นเมื่อผู้ให้บริการ LLM เปลี่ยนโมเดล นโยบายการเก็บข้อมูล หรือแนวทางการจัดการข้อมูล
นอกจากนี้ ควรตั้งสมมติฐานว่า system prompt อาจถูกเปิดเผยได้ในที่สุด และออกแบบระบบให้ทนทานต่อการรั่วไหลบางส่วน แทนที่จะพึ่งพาความลับของ prompt เพียงอย่างเดียว
บทสรุป
ยิ่งเอเจนต์ฉลาดขึ้น ขอบเขตการควบคุมก็ยิ่งสำคัญมากขึ้นตามไปด้วย การรักษาความปลอดภัยของ AI Agent จึงไม่ใช่การเพิ่มเครื่องมือเพียงชิ้นเดียว แต่เป็นการออกแบบสถาปัตยกรรมทั้งระบบให้มีขอบเขตอำนาจที่ชัดเจน สิทธิ์ขั้นต่ำ และความสามารถในการสังเกตการกระทำทุกขั้นตอน องค์กรที่เข้าใจเรื่องนี้ตั้งแต่ต้นจะได้เปรียบในการนำ AI มาใช้อย่างปลอดภัยและยั่งยืน
บทความนี้เรียบเรียงและแปลเป็นภาษาไทยเพื่อการศึกษาและเผยแพร่ข้อมูล โดยอ้างอิงจากบทความต้นฉบับ “Understanding AI Agent Architecture and Security Risks” ของ K. Ashish Kumar (Secure Debug) และแหล่งข้อมูลที่เกี่ยวข้อง เนื้อหาและตัวเลขอ้างอิงจากเอกสารเผยแพร่ของผู้เขียน ณ วันที่เขียนบทความ ซึ่งอาจมีการเปลี่ยนแปลงได้โดยไม่ต้องแจ้งล่วงหน้า บริษัท ไอดินนายด์ จำกัด ไม่มีส่วนเกี่ยวข้องกับการพัฒนาโมเดลหรือเครื่องมือใดที่กล่าวถึงในบทความนี้
แหล่งอ้างอิง: When AI Starts Acting: Security Implications of Agentic AI — K. Ashish Kumar (Secure Debug)